 / marcus
Содержание
Код — это договорённость о том, какой набор сигналов что означает. Перевод сообщения в сигналы называют кодированием, обратный перевод — декодированием. Без такой договорённости цепочка нулей и единиц остаётся просто цепочкой.
Код — это таблица соответствия
С кодами Вы встречаетесь каждый день, просто не называете их так.
| Сигнал | Что означает |
|---|---|
| Красный свет светофора | стойте |
| Один длинный звонок в школе | урок начался |
| Число 112 на телефоне | вызов экстренных служб |
| Смайлик 👍 в переписке | согласен |
В каждом случае есть набор сигналов и правило, по которому их понимают. Правило можно записать таблицей: слева сигнал, справа значение. Такая таблица и есть код.
Один и тот же сигнал в разных кодах значит разное. Кивок головой в России означает «да», а в Болгарии — «нет». Поэтому код должны знать обе стороны: и та, что отправляет сообщение, и та, что получает.
Равномерный код
Попробуем придумать код для букв. В нашем распоряжении только нули и единицы. Самое простое решение — дать каждой букве цепочку одинаковой длины.
Для 33 букв русского алфавита нужно шесть битов: пяти хватает лишь на 32 сочетания. Раздадим буквам номера по порядку:
А  000000
Б  000001
В  000010
Г  000011
...
Я  100000
Код, в котором все цепочки одной длины, называют равномерным. У него важное достоинство: сообщение легко разрезать на буквы. Отсчитали шесть битов — буква, ещё шесть — следующая. Пробелы и паузы не нужны.
Так устроен шрифт Брайля для незрячих. Каждый знак — клетка из шести точек, и каждая точка либо выпуклая, либо нет. Шесть точек дают 2⁶ = 64 сочетания: этого хватает на буквы, цифры и знаки препинания.
Недостаток равномерного кода — расточительность. Редкая буква «Ъ» занимает столько же места, сколько частая «О».
Неравномерный код
В 1830-х годах, когда появился телеграф, каждую букву передавали вручную, нажимая на ключ. Чем короче были сигналы, тем быстрее шла передача. Поэтому в азбуке Морзе частым буквам достались короткие цепочки, а редким — длинные.
| Буква | Код Морзе |
|---|---|
| Е | · |
| Т | — |
| А | · — |
| Н | — · |
| Ш | — — — — |
Код, в котором цепочки разной длины, называют неравномерным. Сообщение в нём получается короче, чем в равномерном.
Но появляется новая трудность. Примем сигнал «точка, тире». Это буква «А» или две буквы — «Е» и «Т»? По самим сигналам понять нельзя. Телеграфисты решали задачу паузами: между буквами делали промежуток подлиннее. Пауза стала третьим знаком кода, и передача замедлилась.
Условие Фано
Можно ли составить неравномерный код, который читается без пауз? Можно. Для этого ни одна цепочка не должна быть началом другой. Это правило называют условием Фано, а коды, которые его выполняют, — префиксными.
Возьмём четыре буквы и такой код:
А  0
Б  10
В  110
Г  111
Проверим условие. Код буквы «А» — 0, а остальные цепочки начинаются с единицы. Код «Б» — 10, а цепочки «В» и «Г» начинаются с 11. Ни одна цепочка не служит началом другой.
Теперь расшифруем сообщение 0101100111. Читаем слева направо и останавливаемся, как только набралась цепочка из таблицы.
0 | 10 | 110 | 0 | 111
А   Б    В    А    Г
Получилось «АБВАГ», и другого прочтения нет. Удобно представлять такой код в виде дерева: от корня идём влево по нулю и вправо по единице, пока не упрёмся в букву.
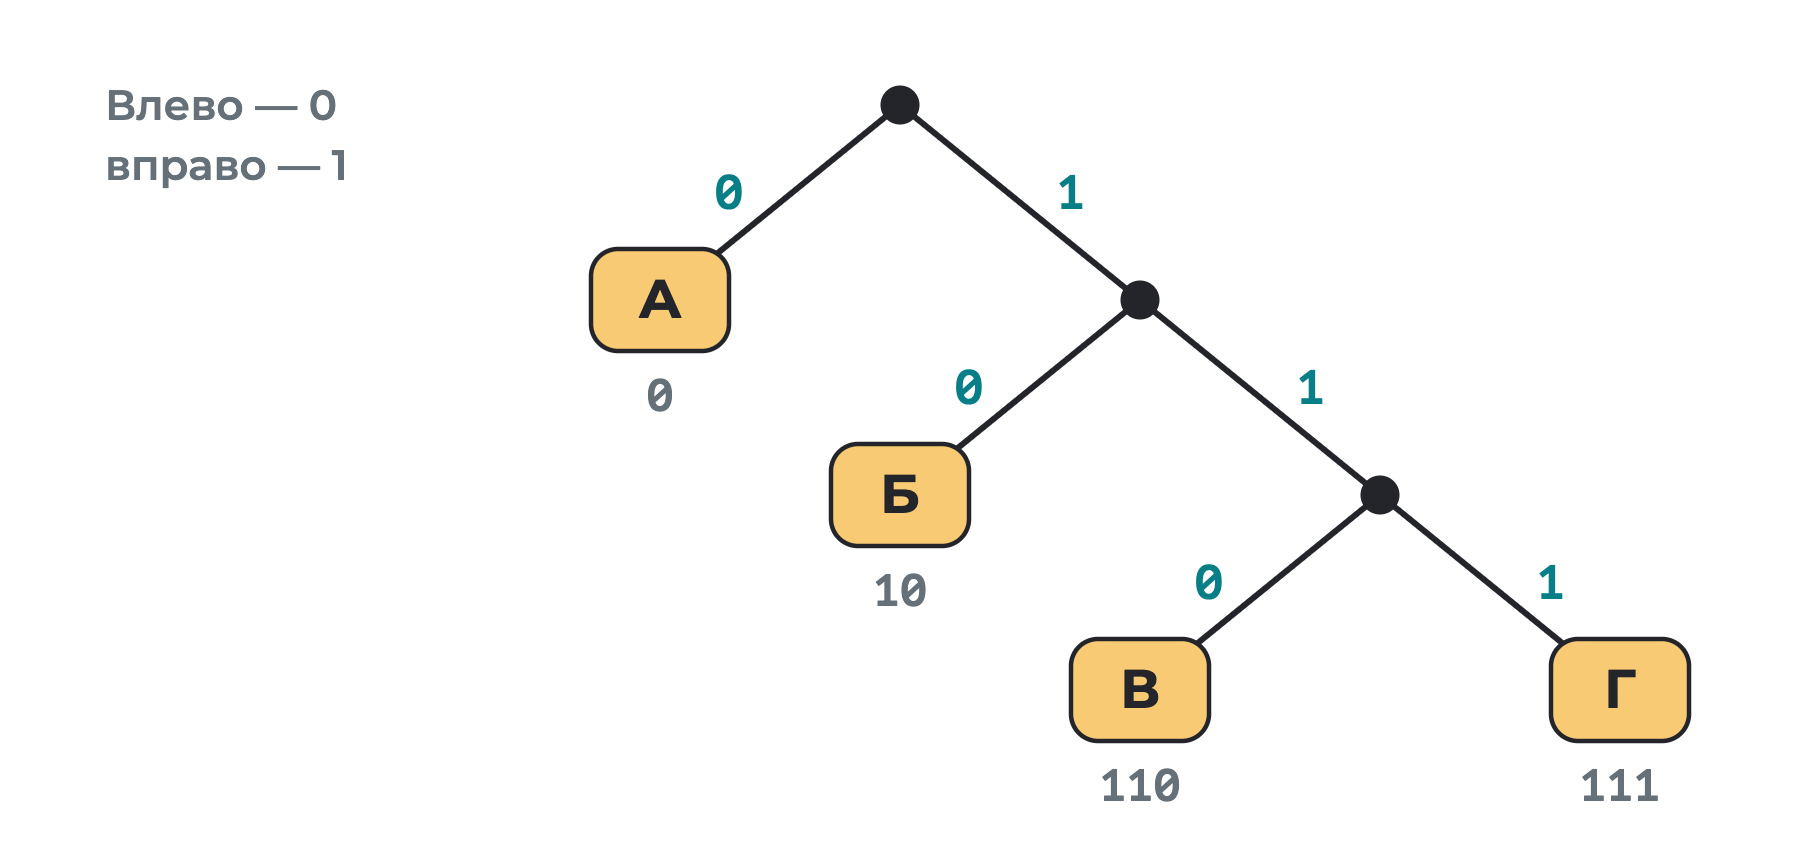
Буквы стоят только на концах веток. Поэтому, дойдя до буквы, мы точно знаем, что цепочка закончилась.
Сравним с кодом, который условие нарушает: А — 0, Б — 01, В — 1. Сообщение 01 можно прочитать и как «Б», и как «АВ». Так происходит потому, что код «А» — начало кода «Б».
Коды, которые находят ошибки
Иногда в код специально добавляют лишние знаки — не для смысла, а для проверки.
Посмотрите на штрихкод на любой упаковке. Под полосками напечатано 13 цифр. Первые двенадцать обозначают страну, производителя и товар, а последняя — контрольная. Её вычисляют по первым двенадцати:
- Сложите цифры, стоящие на нечётных местах: первую, третью, пятую и так далее.
- Сложите цифры на чётных местах и умножьте сумму на 3.
- Сложите оба результата.
- Контрольная цифра дополняет эту сумму до ближайшего числа, которое делится на 10.
Проверим на коде 4600123456782. Нечётные места: 4 + 0 + 1 + 3 + 5 + 7 = 20. Чётные: 6 + 0 + 2 + 4 + 6 + 8 = 26, после умножения на три — 78. Вместе 98. До ста не хватает двух — последняя цифра кода действительно 2.
Если сканер на кассе прочитал одну цифру неправильно, сумма не сойдётся, и касса попросит провести товар ещё раз. Тот же приём используют в номерах банковских карт.
QR-код, придуманный в Японии в 1994 году, идёт дальше. В нём столько запасных данных, что он читается, даже если часть картинки испачкана или оторвана.
Частые вопросы
Код и шифр — одно и то же?
Нет. Шифр нужен, чтобы скрыть смысл от посторонних. Код ничего не прячет: его таблица известна всем, кто им пользуется. Азбука Морзе — код, а не шифр.
Какой код лучше: равномерный или неравномерный?
Зависит от задачи. Равномерный проще читать и легко найти в нём букву с нужным номером — поэтому текст в памяти компьютера обычно хранят так. Неравномерный экономит место — на нём основано сжатие файлов в архивах.
Обязательно ли код состоит из нулей и единиц?
Нет. В азбуке Морзе знаки — точка, тире и пауза, в штрихкоде — цифры, в светофоре — цвета. Но любой код можно перевести в двоичный, и для компьютера так и делают.
Коротко
- Код — договорённость о том, какие сигналы что означают.
- В равномерном коде все цепочки одной длины; его легко делить на знаки.
- В неравномерном коде частым знакам дают короткие цепочки, и сообщение выходит короче.
- Неравномерный код читается однозначно, если выполняется условие Фано: ни одна цепочка не начинает другую.
- Лишние знаки в коде помогают заметить ошибку — так работает контрольная цифра штрихкода.
Самый важный для компьютера код — запись чисел двумя цифрами. О нём — урок Двоичная система счисления.
Использованная литература
- Префиксный код — Википедия [Электронный ресурс]. — URL: https://ru.wikipedia.org/wiki/Префиксный_код (дата обращения: 09.10.2026).
- Шрифт Брайля — Википедия [Электронный ресурс]. — URL: https://ru.wikipedia.org/wiki/Шрифт_Брайля (дата обращения: 09.10.2026).
- History of QR Code — DENSO WAVE [Электронный ресурс]. — URL: https://www.qrcode.com/en/history/ (дата обращения: 09.10.2026).