 / marcus
Содержание
Компьютер хранит текст как числа. У каждого знака — буквы, цифры, пробела, смайлика — есть номер в общей таблице, а в память попадает этот номер, записанный байтами. Правило, по которому знаки превращаются в байты и обратно, называют кодировкой. Сегодня почти все сайты и приложения пользуются таблицей Юникод и кодировкой UTF-8.
Знак, номер, байты
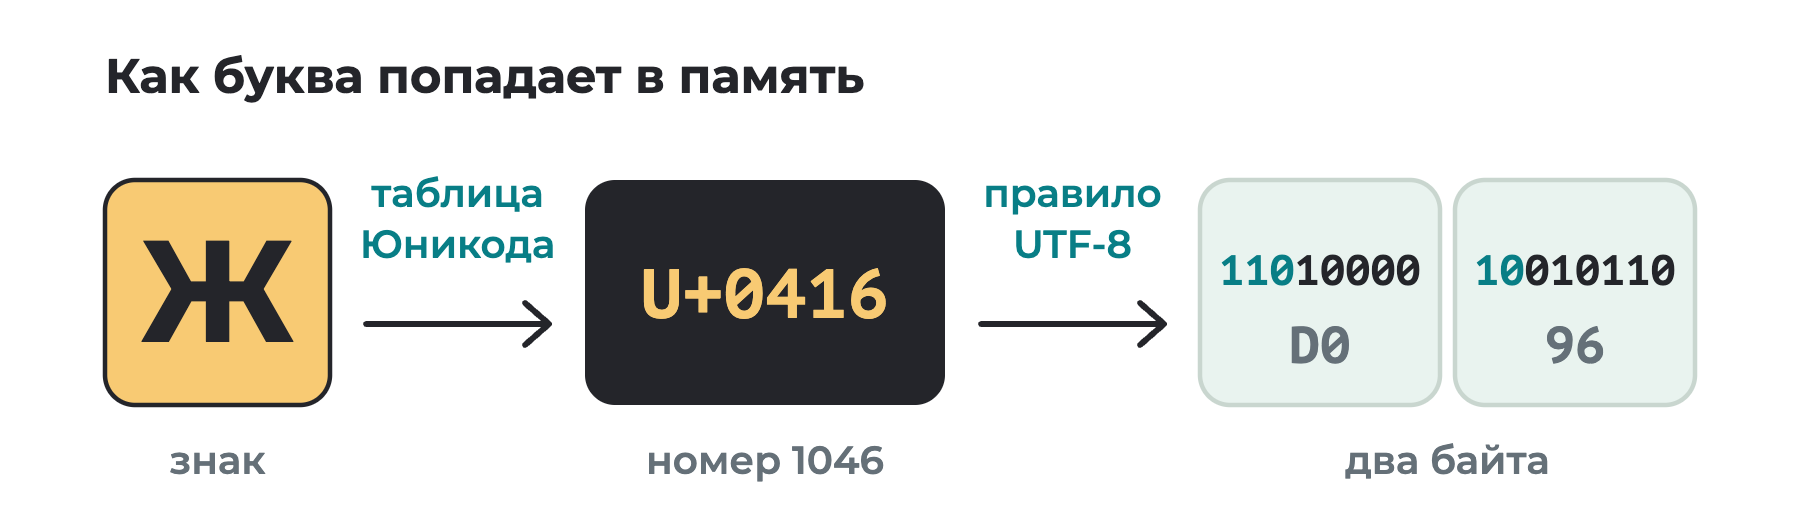
Когда Вы набираете в мессенджере букву «Ж», телефон делает два шага.
- Находит номер знака в таблице. У «Ж» это 1046.
- Записывает номер байтами. Число 1046 в один байт не помещается: байт вмещает только числа до 255. Значит, нужно правило, как разложить номер по нескольким байтам.
Телефон собеседника проходит те же шаги в обратном порядке и рисует на экране «Ж». Всё работает, пока оба пользуются одной таблицей и одним правилом.
ASCII: первые 128 знаков
В 1963 году в США приняли таблицу ASCII — её название читают «аски». На каждый знак в ней отведено семь битов, поэтому номеров всего 2⁷ = 128. Из них 33 достались служебным командам вроде перевода строки, а 95 — латинским буквам, цифрам, знакам препинания и пробелу.
| Знак | Номер | Семь битов |
|---|---|---|
| пробел | 32 | 0100000 |
0 | 48 | 0110000 |
9 | 57 | 0111001 |
A | 65 | 1000001 |
Z | 90 | 1011010 |
a | 97 | 1100001 |
z | 122 | 1111010 |
В таблице заложено несколько удобных закономерностей.
- Буквы идут по алфавиту. Раз
A— это 65, тоB— 66, аC— 67. Поэтому слова легко сортировать: достаточно сравнить числа. - Знак цифры и число — разные вещи. У знака
0номер 48, у знака7— 55. Чтобы из знака цифры получить число, программа вычитает 48. - Заглавная и строчная буквы отличаются на 32. Это ровно один бит:
A—1000001,a—1100001. Чтобы превратить строчную букву в заглавную, достаточно погасить этот бит.
Слово Hi! в памяти — три числа: 72, 105 и 33.
Восьмой бит и «кракозябры»
В байте восемь битов, а ASCII занимает семь. Свободными остались номера от 128 до 255, и каждая страна заполнила их своими буквами. Так появились национальные кодировки. Для русского языка их оказалось сразу несколько: КОИ-8, Windows-1251 и другие. Беда в том, что один и тот же байт означает в них разные буквы.
Запишем слово «Привет» в Windows-1251 и прочитаем те же шесть байтов по другой таблице:
Байты:               CF F0 E8 E2 E5 F2
По Windows-1251:     Привет
По КОИ-8:            оПХБЕР
Байты не изменились — изменилась таблица, по которой их прочитали. Такой испорченный текст прозвали «кракозябрами». Была и вторая беда: в 128 свободных номеров не помещаются сразу русские, греческие и арабские буквы, не говоря о тысячах китайских иероглифов.
Юникод: одна таблица на всех
В 1991 году вышла первая версия Юникода (Unicode) — общей таблицы, в которой свой номер есть у каждого знака каждой письменности. Сейчас в ней больше 150 тысяч знаков: буквы, иероглифы, ноты, математические символы, эмодзи.
Номер знака в Юникоде называют кодовой позицией и пишут так: U+ и шестнадцатеричное число не короче четырёх цифр.
| Знак | Кодовая позиция | Номер в десятичной записи |
|---|---|---|
| A (латинская) | U+0041 | 65 |
| А (русская) | U+0410 | 1040 |
| я | U+044F | 1103 |
| ₽ | U+20BD | 8381 |
| 😀 | U+1F600 | 128 512 |
Первые 128 номеров совпадают с ASCII. А вот латинская A и русская «А» — разные знаки с разными номерами, хотя на экране их не отличить. Поэтому пароль, набранный в русской раскладке, не подойдёт, даже если буквы выглядят так же.
Юникод отвечает только на первый вопрос: какой у знака номер. Как записать номер байтами, решает кодировка.
UTF-8: от одного до четырёх байтов
Проще всего было бы отвести каждому знаку четыре байта. Но тогда обычный английский текст вырос бы вчетверо. В 1992 году программисты Кен Томпсон и Роб Пайк придумали UTF-8 — неравномерный код, в котором частые знаки занимают меньше места.
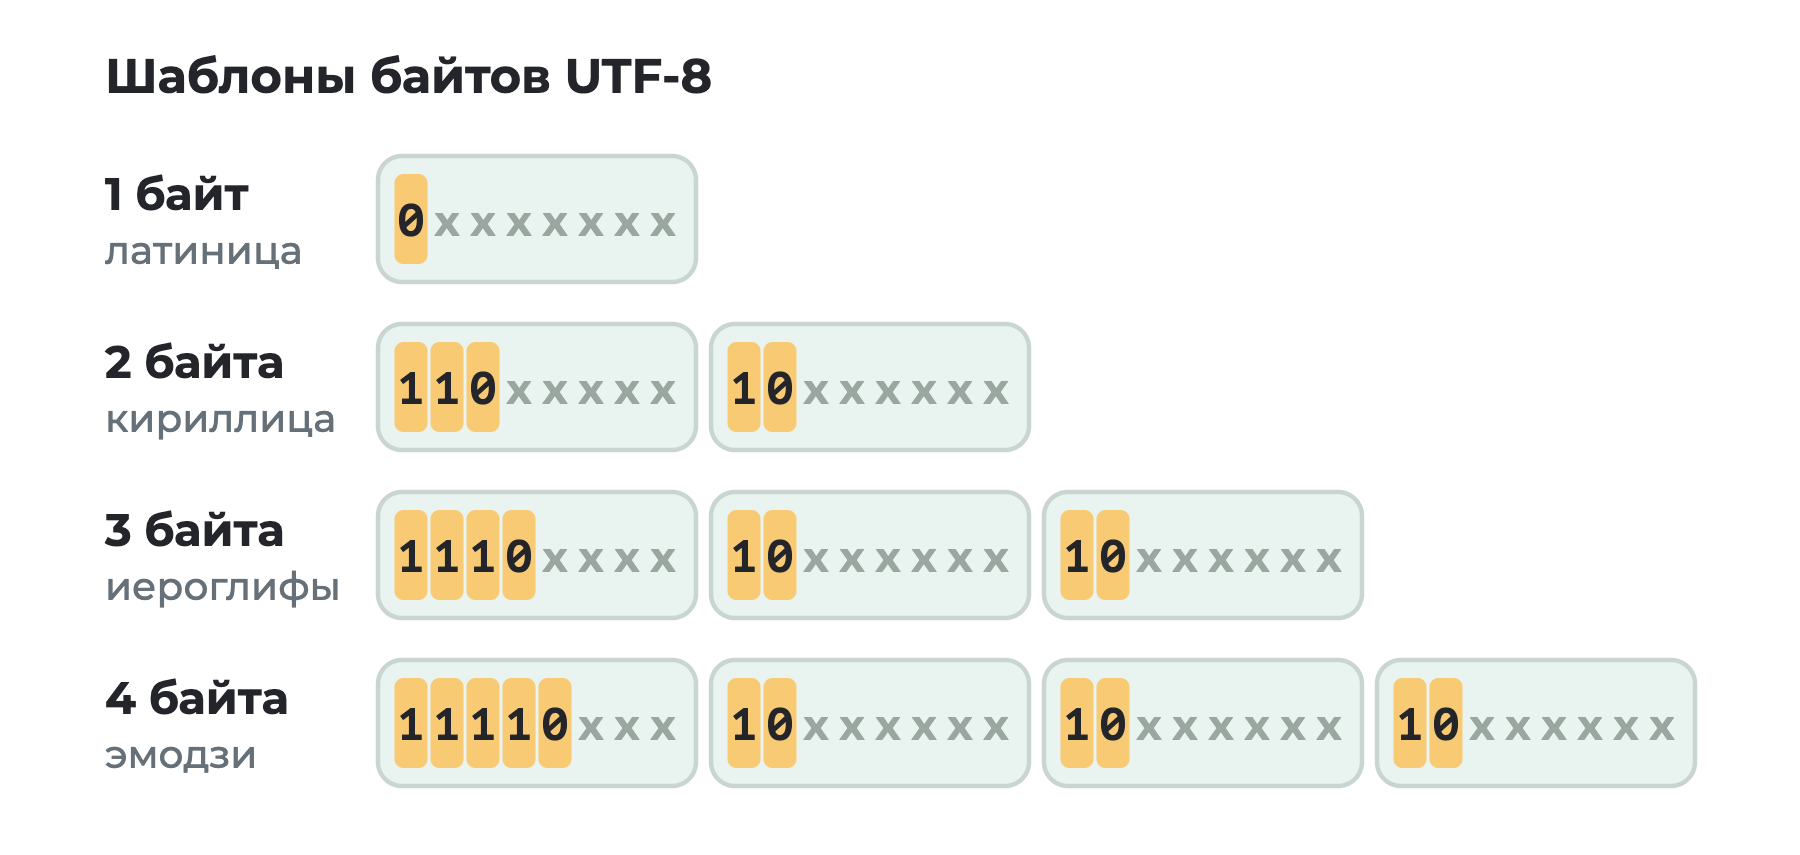
Первые биты каждого байта — служебные. Байт, который начинается с 0, — это знак целиком. Начало 110 означает «знак из двух байтов», 1110 — из трёх, 11110 — из четырёх. С 10 начинаются байты-продолжения. Ни одна из этих пометок не служит началом другой — это условие Фано из урока Коды вокруг нас. Поэтому программа читает поток байтов без разделителей и всегда знает, где кончается знак.
Разберём по битам букву «Ж». Её номер — 1046, в двоичной записи 10000010110. Это 11 битов: в один байт не влезут, а в шаблон из двух байтов помещаются точно — пять битов в первый и шесть во второй.
Биты номера:   10000 010110
Шаблон:        110xxxxx 10xxxxxx
Байты:         11010000 10010110
То же короче:  D0 96
Сколько байтов занимает слово
Число байтов зависит от того, насколько велик номер знака:
- латинские буквы, цифры, пробел и знаки препинания — 1 байт;
- русские буквы — 2 байта;
- знак рубля и большинство иероглифов — 3 байта;
- эмодзи — как правило, 4 байта.
| Текст | Знаков | Байтов в UTF-8 |
|---|---|---|
| school | 6 | 6 |
| школа | 5 | 10 |
| Привет, мир! | 12 | 21 |
| Ок 👍 | 4 | 9 |
В третьей строке девять русских букв дают 18 байтов, ещё три байта — запятая, пробел и восклицательный знак. Русский текст в UTF-8 занимает почти вдвое больше места, чем в Windows-1251. Это плата за то, что в одном сообщении уживаются любые языки и смайлики.
Частые вопросы
Юникод и UTF-8 — одно и то же?
Нет. Юникод — таблица, которая даёт знакам номера. UTF-8 — один из способов записать эти номера байтами. Есть и другие, например UTF-32, где каждый знак занимает ровно четыре байта.
Откуда берутся строки вроде «РџСЂРёРІРµС‚»?
Это слово «Привет», записанное в UTF-8 и прочитанное по таблице Windows-1251. Каждая русская буква заняла два байта, а программа приняла каждый байт за отдельную букву — вместо шести знаков получилось двенадцать. Текст не испорчен: достаточно выбрать правильную кодировку.
Цифра «5» в тексте и число 5 хранятся одинаково?
Нет. Знак «5» — это номер 53, байт 00110101. Число пять — байт 00000101. Компьютер не знает, что перед ним, пока программа не решит, как читать эти биты.
Коротко
- Текст хранится числами: таблица даёт знаку номер, кодировка записывает номер байтами.
- В ASCII семь битов и 128 знаков:
A— 65,a— 97,0— 48. - В национальных кодировках один байт означает разные буквы; при неверной кодировке получаются «кракозябры».
- Юникод — общая таблица для всех письменностей; номер пишут как
U+0410. - В UTF-8 знак занимает от одного до четырёх байтов: латинская буква — 1, русская — 2, эмодзи — обычно 4.
- Первые биты байта в UTF-8 сообщают, сколько байтов в знаке.
Буквы стали числами. Но и с самими числами не всё просто: как записать минус и что случится, если числу не хватит разрядов, — в уроке Целые числа в памяти.
Использованная литература
- ASCII — Википедия [Электронный ресурс]. — URL: https://ru.wikipedia.org/wiki/ASCII (дата обращения: 09.10.2026).
- Юникод — Википедия [Электронный ресурс]. — URL: https://ru.wikipedia.org/wiki/Юникод (дата обращения: 09.10.2026).
- UTF-8 — Википедия [Электронный ресурс]. — URL: https://ru.wikipedia.org/wiki/UTF-8 (дата обращения: 09.10.2026).
- RFC 3629: UTF-8, a transformation format of ISO 10646 [Электронный ресурс]. — URL: https://www.rfc-editor.org/rfc/rfc3629 (дата обращения: 09.10.2026).