 / marcus
Содержание
В прошлой статье мы познакомились с указателями: научились получать адрес переменной, хранить его в указателе и обращаться к переменной через разыменование. Тогда мог остаться вопрос: зачем всё это нужно? Сегодня ответим на него.
В этой статье разберём динамическую память: выделение памяти оператором new и освобождение оператором delete. Без неё не получится написать программу, которой нужно больше нескольких мегабайт памяти, а настоящим программам нужно гораздо больше. По пути заглянем «под капот» массивов и узнаем, как на самом деле работают квадратные скобки.
После этой статьи Вы сможете:
- объяснить, почему массив — это непрерывный участок памяти и почему имя массива ведёт себя как указатель;
- узнать размер типа, переменной или массива с помощью
sizeof; - посчитать, куда сдвинется указатель после
p + 1, — адресная арифметика; - объяснить, что на самом деле означает запись
data[i]; - отличить стек от кучи и объяснить, почему большой массив не помещается в стек;
- создать динамический массив через
new[]и освободить его черезdelete[]; - найти утечку памяти и исправить её.
Почему программа падает на большом массиве
Начнём с эксперимента. Объявим массив на 2500 элементов типа int и выведем сообщение:
#include <iostream>

int main() {
    int data[2'500];
    std::cout << "OK!\n";
    return 0;
}OK!
Process finished with exit code 0Программа дошла до return 0 и завершилась без ошибок. Апострофы в числе 2'500 — просто разделители разрядов, они появились в C++14 и помогают читать большие числа. А теперь увеличим массив в тысячу раз — до 2,5 миллиона элементов:
#include <iostream>

int main() {
    int data[2'500'000];
    std::cout << "OK!\n";
    return 0;
}Process finished with exit code 139 (interrupted by signal 11:SIGSEGV)Знакомая по прошлому уроку ошибка: код 139 и сигнал SIGSEGV — нарушение доступа к памяти. Но на этот раз мы не разыменовывали nullptr. Причина в другом: массив не поместился в стек — область памяти, где живут обычные переменные. Чтобы понять, что такое стек и как создать массив хоть на миллиард элементов, разберём сначала три небольшие темы: как массив устроен в памяти, оператор sizeof и адресную арифметику.
Что такое массив на самом деле
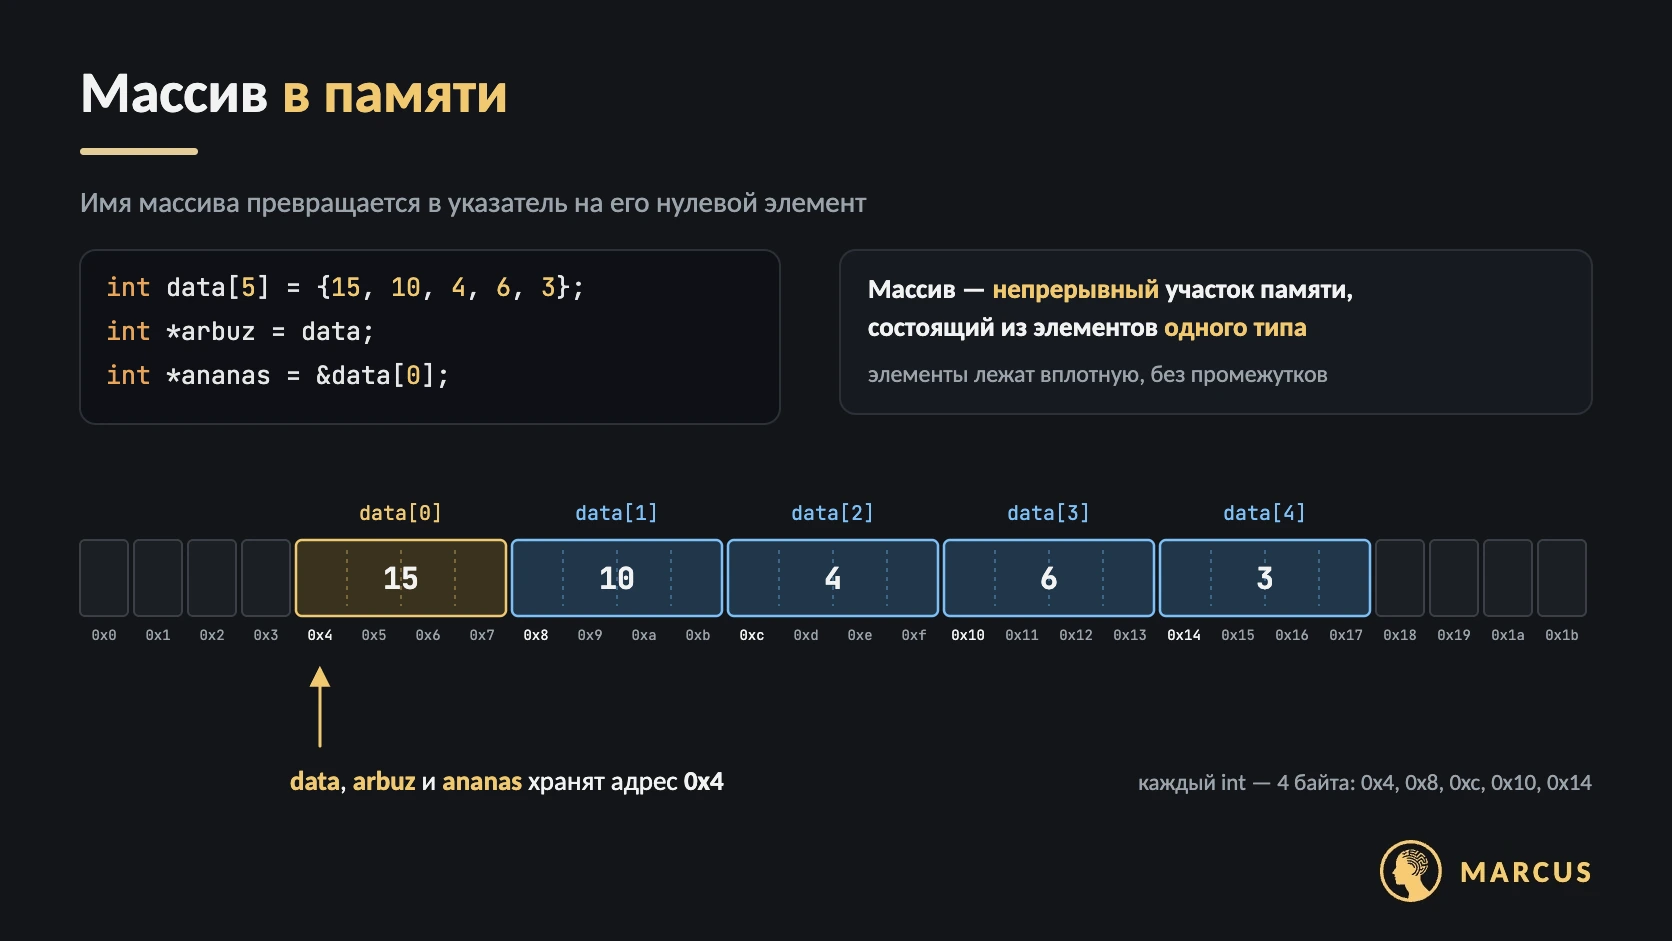
В этом определении важны две детали. Первая — один тип данных: массив хранит только int, только double или только char. Вторая — непрерывность: элементы лежат в памяти вплотную друг к другу, без промежутков.
Посмотрим, как в памяти лежит массив data из пяти чисел 15, 10, 4, 6, 3. Как и в прошлом уроке, представим память в виде ленты из байтов, у каждого из которых есть адрес. Байт — наименьший кусочек памяти, у которого в C++ есть собственный адрес: получить адрес отдельного бита нельзя.
Пусть число 15 лежит начиная с адреса 0x4. int занимает 4 байта, поэтому 15 занимает байты с 0x4 по 0x7. Десятка лежит сразу после неё, с адреса 0x8, — никаких пропусков между элементами нет. Дальше так же идут 4, 6 и 3.
Имя массива превращается в указатель
Что будет, если вывести на экран само имя массива — std::cout << data? Если Вы знакомы с Python, то ожидаете увидеть элементы: 15, 10, 4, 6, 3. В C++ это не так: на экран выведется адрес.
Так работает правило, которое по-английски называется array decays to pointer — «массив превращается в указатель». Когда имя массива используется в выражении, оно автоматически превращается в указатель на нулевой элемент. Поэтому data можно присвоить указателю, а ещё адрес начала массива можно получить через &data[0]:
#include <iostream>

int main() {
    int data[5] = {15, 10, 4, 6, 3};
    int *arbuz = data;
    int *ananas = &data[0];

    std::cout << (data == arbuz ? "yes" : "no") << "\n";
    std::cout << (data == ananas ? "yes" : "no") << "\n";
    std::cout << (arbuz == ananas ? "yes" : "no") << "\n";
    return 0;
}yes
yes
yesВсе три сравнения верны: data, arbuz и ananas указывают на один и тот же байт — 0x4. В этом нет ничего странного: две переменные типа int тоже могут хранить одно и то же число. Имена arbuz и ananas — напоминание из прошлого урока, что указатель можно назвать как угодно.
Оператор sizeof
Оператор sizeof возвращает размер типа данных, переменной или литерала в байтах:
#include <iostream>

int main() {
    std::cout << sizeof(int) << "\n";     // 4
    std::cout << sizeof(151) << "\n";     // 4

    double pi = 3.1415;
    std::cout << sizeof(pi) << "\n";      // 8
    std::cout << sizeof(int *) << "\n";   // 8

    int data[5];
    std::cout << sizeof(data) << "\n";    // 5 * 4 = 20
    return 0;
}| Выражение | Результат | Почему |
|---|---|---|
sizeof(int) | 4 | Размер типа int |
sizeof(151) | 4 | Целочисленный литерал по умолчанию имеет тип int |
sizeof(pi) | 8 | Переменная типа double |
sizeof(int *) | 8 | На 64-битных системах любой указатель — int *, double *, char ** — занимает 8 байт |
sizeof(data) | 20 | 5 элементов по 4 байта |
Адресная арифметика
К указателю можно прибавить целое число. Но прибавляется не столько байтов, сколько написано, а столько элементов:
Пусть переменная a лежит по адресу 0x4, а указатель arbuz хранит этот адрес. Что окажется в arbuz после строки arbuz = arbuz + 1? Не 0x5! arbuz — указатель на int, поэтому к адресу прибавится sizeof(int) * 1 = 4, и получится 0x8 — адрес байта, который идёт сразу после переменной a.
#include <iostream>

int main() {
    int a = 7;
    int *arbuz = &a;
    std::cout << arbuz << "\n";

    arbuz = arbuz + 1;
    std::cout << arbuz << "\n";
    return 0;
}0x7ffed56084ac
0x7ffed56084b0Адреса у Вас будут другими, но разница между ними всегда будет 4: 0x...ac + 4 = 0x...b0.
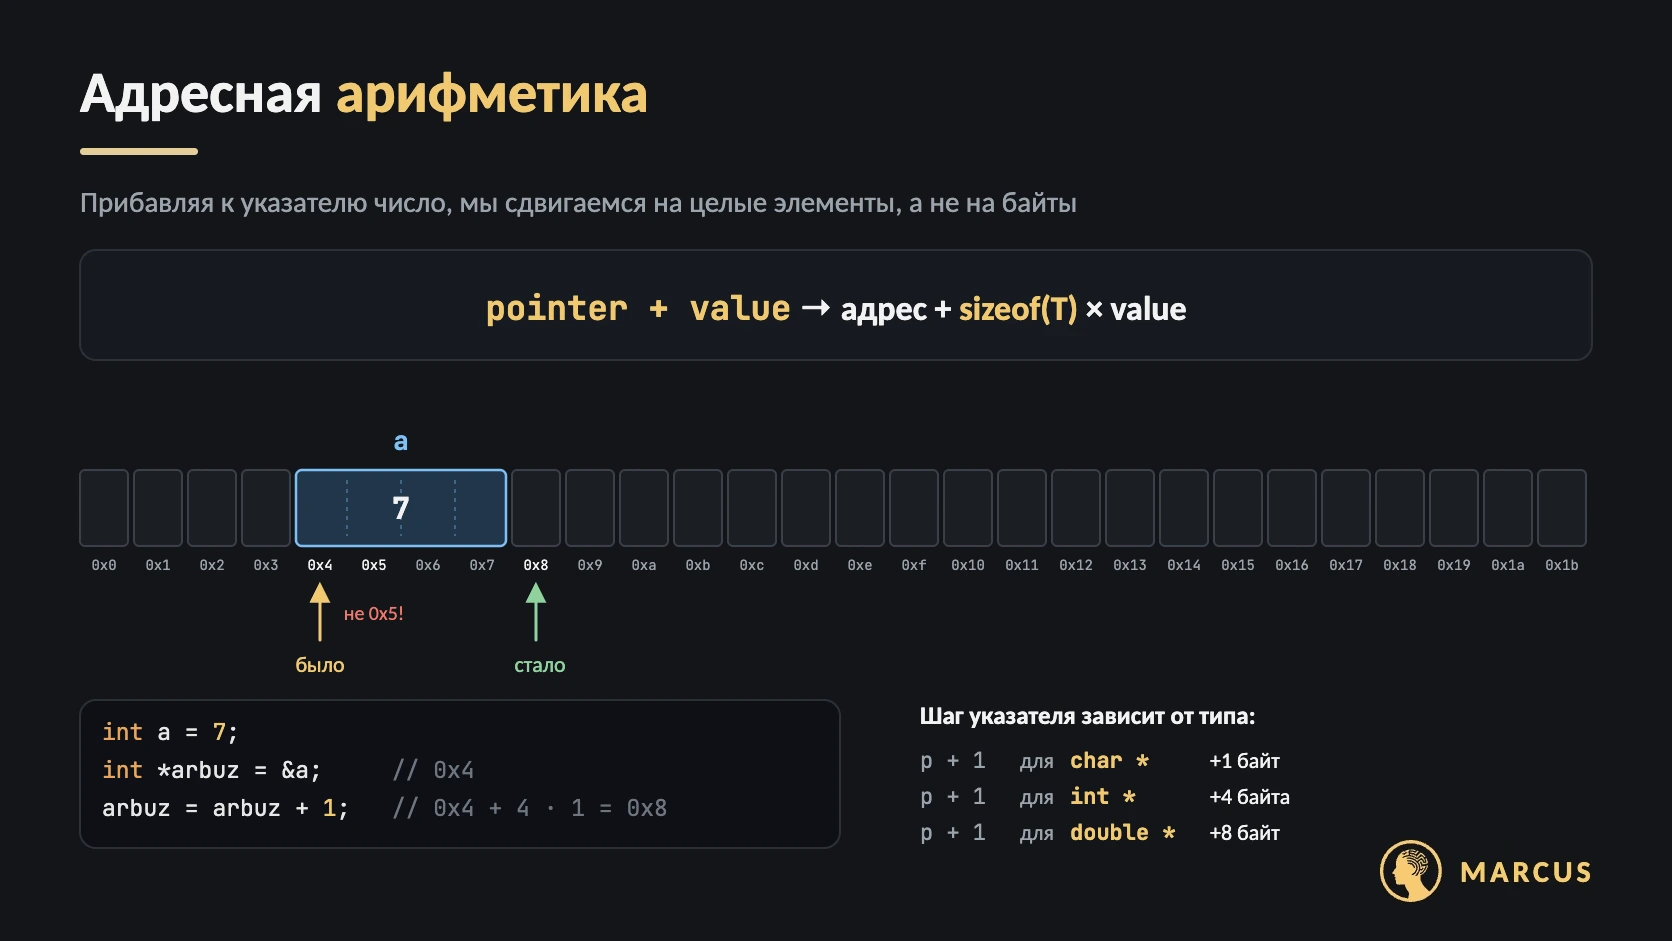
Вычитание работает по тому же правилу: p - 2 сдвигает указатель на 2 * sizeof(T) байт назад. Шаг всегда равен размеру типа, на который указывает указатель: для char * — 1 байт, для int * — 4, для double * — 8.
Как работают квадратные скобки
Соберём вместе всё, что узнали. data — указатель на нулевой элемент массива, а к указателю можно прибавлять целые числа. Прибавим 0, 1, 2… и разыменуем результат:
#include <iostream>

int main() {
    int data[5] = {15, 10, 4, 6, 3};
    std::cout << *(data + 0) << "\n";  // data[0]
    std::cout << *(data + 1) << "\n";  // data[1]
    std::cout << *(data + 2) << "\n";  // data[2]
    std::cout << *(data + 3) << "\n";  // data[3]
    std::cout << *(data + 4) << "\n";  // data[4]
    return 0;
}15
10
4
6
3Проследим *(data + 2). data хранит 0x4. Прибавляем 2 — получаем 0x4 + 2 * 4 = 0xc. Разыменовываем этот адрес и получаем то, что там лежит, — 4. Ровно то же самое вернула бы запись data[2].
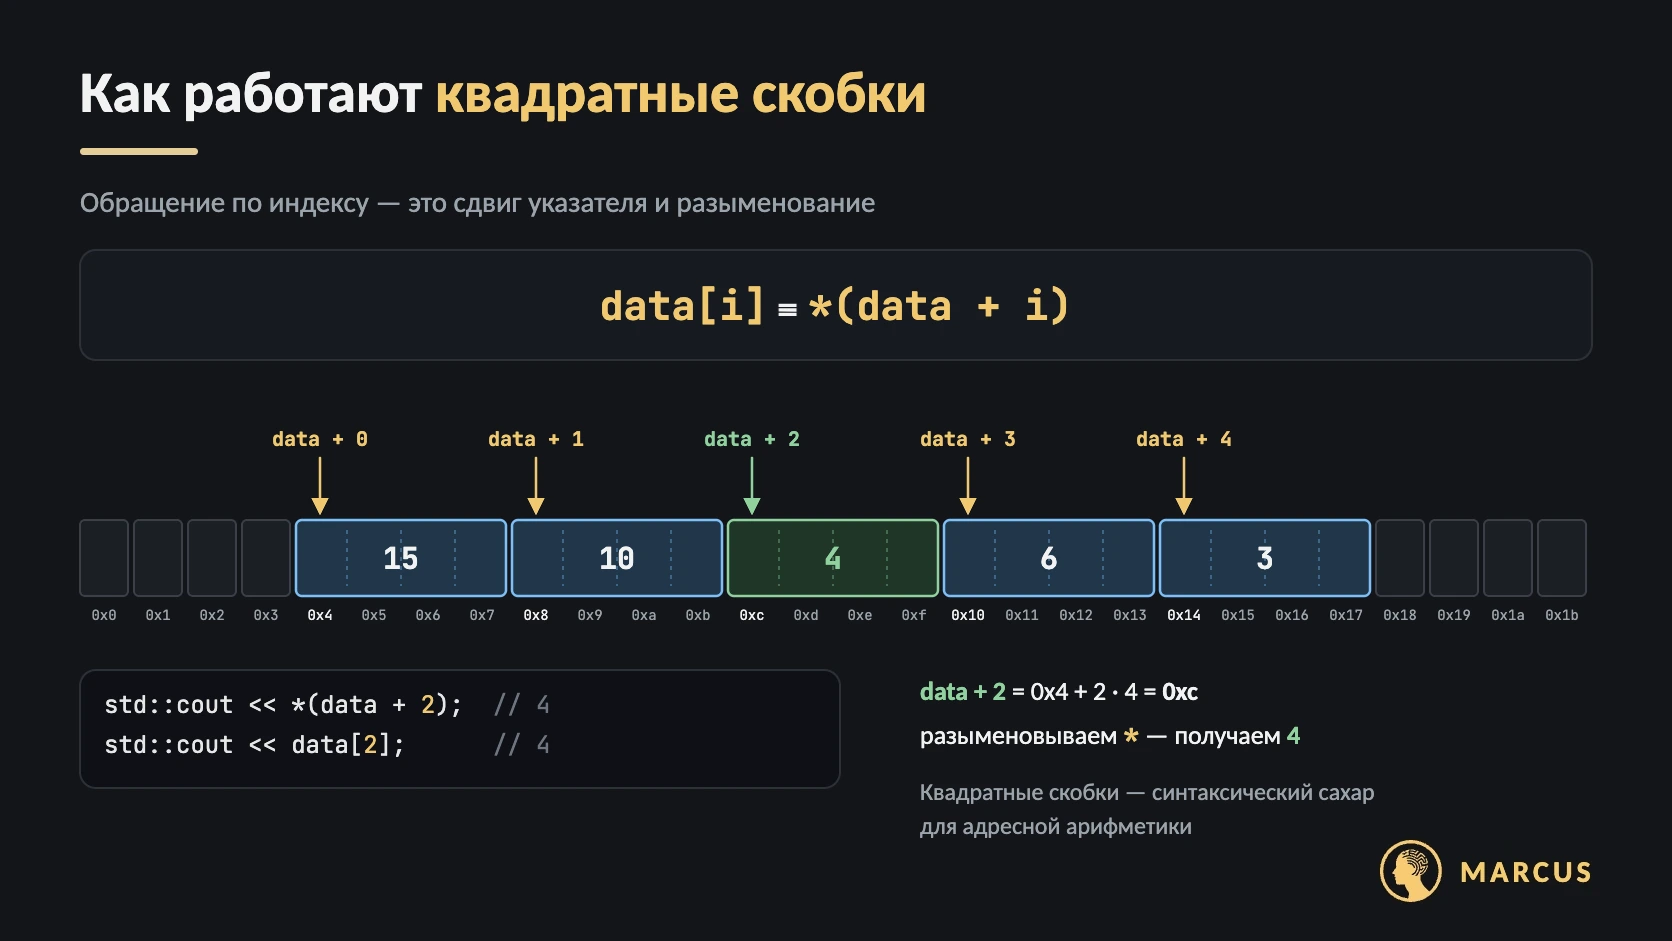
Теперь понятно и то, почему индексы начинаются с нуля: индекс — это сдвиг от начала массива. Нулевой элемент лежит прямо по адресу data, сдвигаться никуда не нужно.
Стек и куча
Переходим к главному. Сначала договоримся о словах: в книгах и статьях одни и те же вещи называют по-разному. «Стек», «стековая память», «автоматическая память» — это одно. «Куча» и «динамическая память» — другое. Разберём их по очереди.
Стек
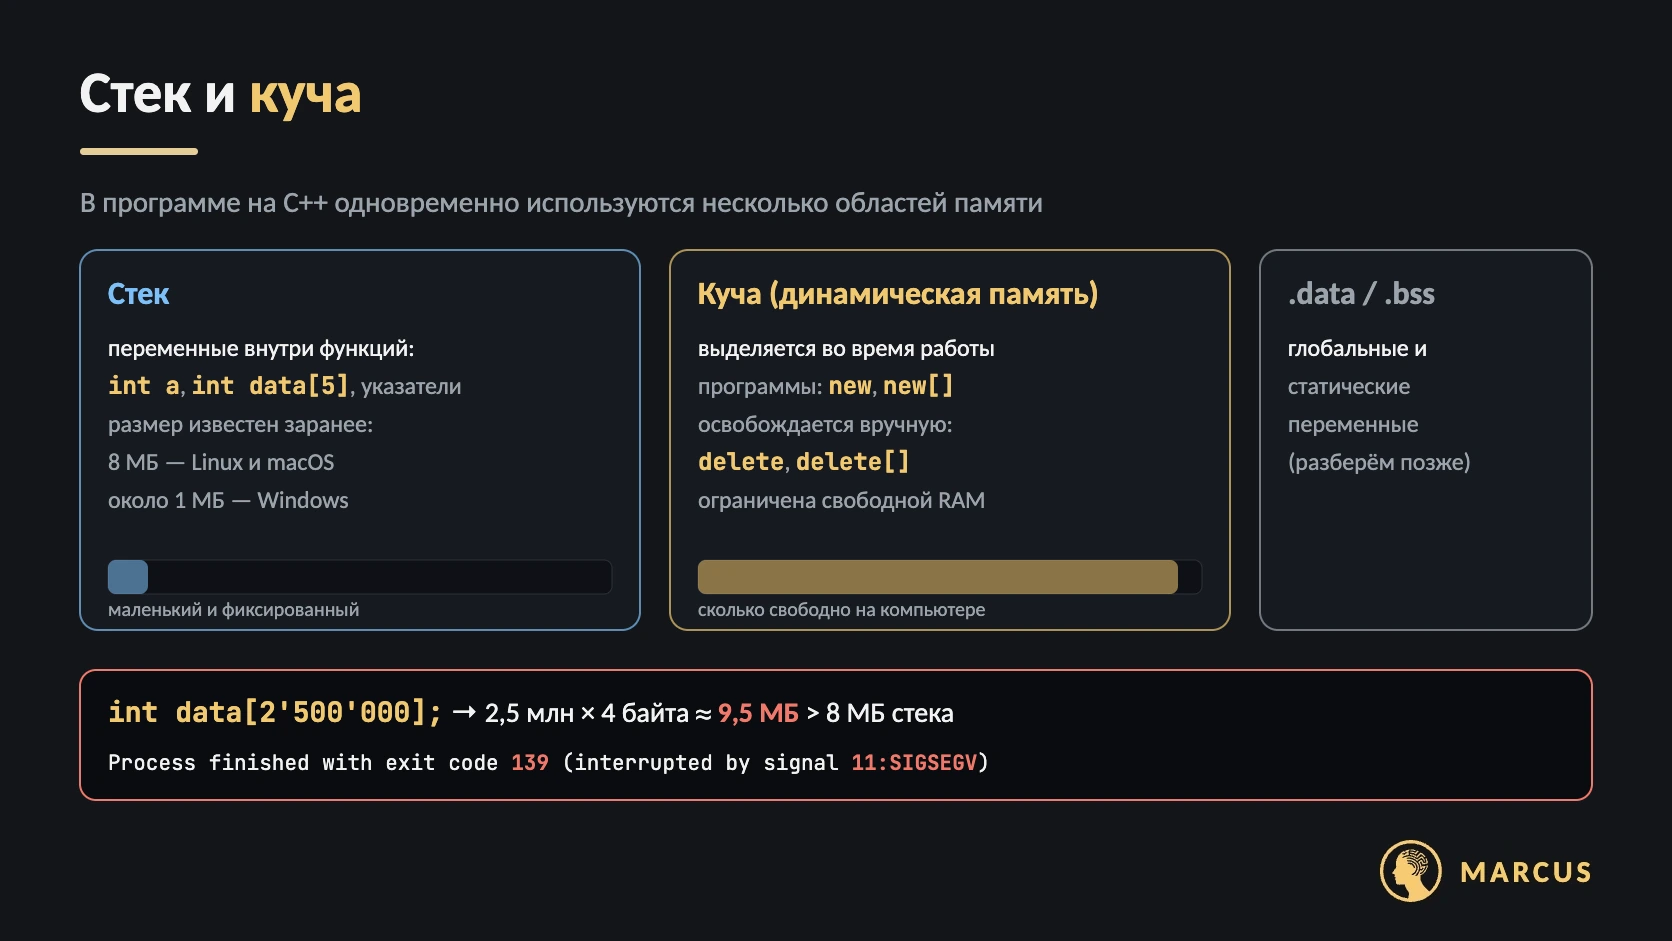
Стек — область памяти, в которой лежат переменные, объявленные внутри функций, например внутри main. Все переменные, которые мы создавали в предыдущих уроках, — int a, массивы int data[5], указатели — жили на стеке.
8 МБ — это мало. Браузер легко занимает сотни мегабайт, а компьютерные игры — гигабайты. Посчитаем, сколько int поместится в стек на Linux или macOS:
8 МБ / 4 байта = 8 · 1024 · 1024 / 4 = 2 097 152Около 2 миллионов — и это без учёта других переменных, которые тоже лежат на стеке. Массив из 2,5 миллиона int занимает примерно 9,5 МБ и в стек не помещается. Отсюда и ошибка из начала урока: программа выходит за пределы стека, и операционная система её останавливает.
Для счётчиков циклов и обычных переменных стека хватает с запасом, поэтому пользоваться им мы продолжим. Проблемы начинаются с большими массивами — и тех, и других в реальных программах много. Лимит стека можно увеличить в настройках системы, но правильный путь — куча.
Куча
Выделять память в куче можно, пока хватает свободной оперативной памяти компьютера: хоть гигабайт, хоть десять. Именно так работают игры: в главном меню им нужно немного памяти, а когда на экране взрывы и погони — память выделяется дополнительно.
Кроме стека и кучи в программе есть ещё области .data и .bss — в них хранятся, например, глобальные переменные. До них мы дойдём позже. Сейчас важно понять, что программа использует все области одновременно: небольшие переменные — на стеке, большие данные — в куче.
| Стек | Куча | |
|---|---|---|
| Что там лежит | Переменные, объявленные внутри функций | То, что выделено через new и new[] |
| Когда выделяется | При запуске программы | Во время работы, по запросу |
| Размер | Фиксированный: около 8 МБ (Linux, macOS), около 1 МБ (Windows) | Сколько свободно оперативной памяти |
| Кто освобождает | Автоматически, при выходе из блока {} | Программист — через delete и delete[] |
Динамический массив: операторы new[] и delete[]
Для выделения динамической памяти в C++ есть операторы new и new[]. Они возвращают указатель на первый байт выделенной памяти. Память, полученную через них, программа обязана вернуть операционной системе с помощью delete и delete[] соответственно.
Начнём с массивов — для них используются new[] и delete[]. Вот как создать массив на 10 миллионов int, который в стек точно не поместился бы:
#include <iostream>

int main() {
    int huge_size = 10'000'000;
    int *huge_data = new int[huge_size];

    for (int i = 0; i < huge_size; i++) {
        huge_data[i] = i;
    }
    std::cout << huge_data[huge_size - 1] << "\n";

    delete[] huge_data;
    return 0;
}9999999Разберём строку int *huge_data = new int[huge_size];:
new— запрос к операционной системе во время работы программы: «дай мне память»;int[huge_size]— сколько памяти нужно:sizeof(int) * huge_size= 4 · 10 000 000 = 40 000 000 байт, примерно 38 МБ. Вместоintможно указать любой тип:double,char,bool,long longи дажеint *;- операционная система ищет свободный непрерывный участок такого размера, закрепляет его за нашей программой и возвращает адрес его первого байта;
- этот адрес мы сохраняем в указатель
huge_data— он лежит на стеке и занимает 8 байт, а сам массив — в куче.
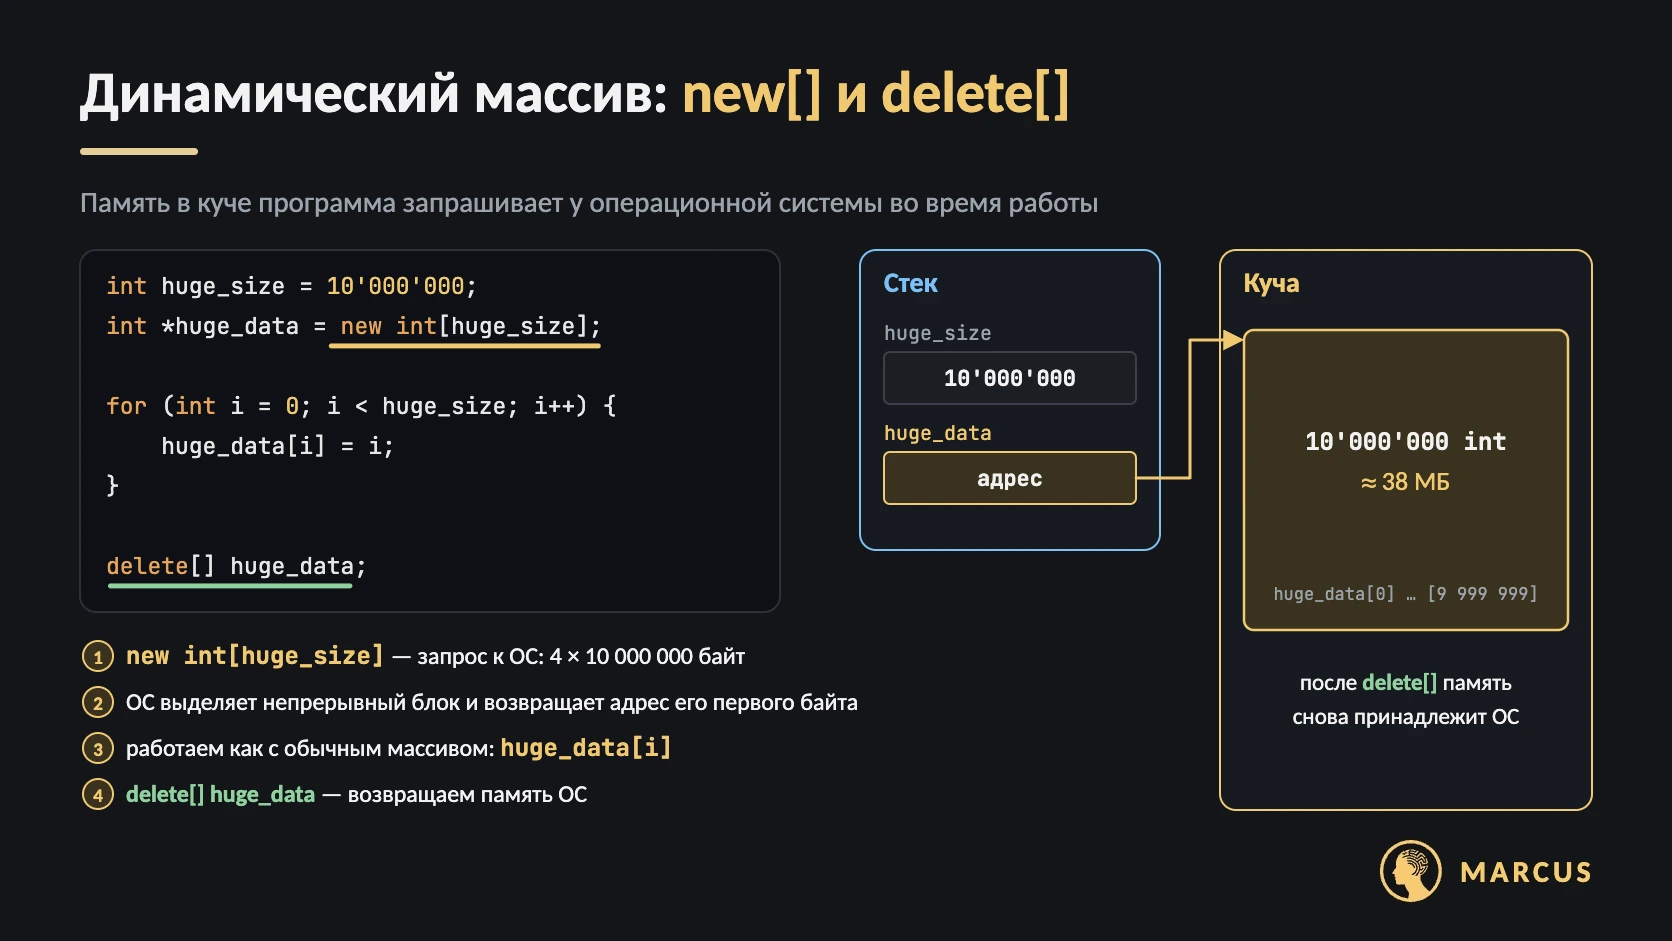
Дальше с динамическим массивом работают точно так же, как с обычным: индексация, ввод с клавиатуры, вывод, сортировка — всё через те же квадратные скобки. Это работает, потому что huge_data — указатель на нулевой элемент, а huge_data[i] — это *(huge_data + i). Отличаются только создание через new[] и освобождение через delete[].
Зачем писать delete[]
Представьте: программа запросила у операционной системы 4 ГБ, поработала с ними и больше в них не нуждается. Откуда системе знать, что память освободилась? Пока программа работает, система считает эти 4 ГБ занятыми и не может отдать их браузеру или игре.
delete[] huge_data; — это сигнал операционной системе: «память по этому указателю мне больше не нужна». После этого система может отдать её другим программам.
Пример: массив температур
Динамически можно выделять память под массив любого размера — не только огромного. Создадим массив из 1000 значений double:
#include <iostream>

int main() {
    double *temps = new double[1000];

    temps[0] = 1.1;
    temps[1] = 2.0;
    temps[1] *= temps[0];   // то же, что *(temps + 1) *= *(temps + 0)
    std::cin >> temps[7];
    std::cout << temps[1] << " " << temps[7] << "\n";

    delete[] temps;
    return 0;
}7.5
2.2 7.5Элементы, которым мы не присвоили значения, содержат мусор — как и в обычном массиве без инициализации. Квадратные скобки после delete по стилю кода принято прижимать к слову delete: delete[] temps;. Компилятору пробелы не важны.
new и delete для одного объекта
Операторы без квадратных скобок выделяют память под один объект. В круглых скобках можно сразу задать значение:
#include <iostream>

int main() {
    int *value = new int(9);
    std::cout << *value << "\n";
    delete value;
    return 0;
}9Для одного int так делать бессмысленно: он занимает 4 байта и спокойно помещается на стеке — проще написать int value = 9;. Выделение одиночных объектов пригодится, когда мы дойдём до классов: например, объект «студент» с именем, оценками и номером студенческого билета.
| Выделили | Освобождаем | Для чего |
|---|---|---|
new int(9) | delete value; | Один объект |
new int[n] | delete[] data; | Массив |
Утечка памяти
Что будет, если забыть написать delete[]? Возникнет утечка памяти.
В некоторых языках, например в Python или Java, есть сборщик мусора: он сам находит память, на которую никто не ссылается, и освобождает её. В C и C++ сборщика мусора нет — следить за памятью должен программист. Посмотрим, как возникает утечка:
for (int i = 0; i < 3; i++) {
    int *data = new int[1'000'000'000];
    // работаем с массивом: заполняем, сортируем...
}
// delete[] не было ни в цикле, ни после него
Каждая итерация выделяет миллиард int — 4 миллиарда байт, около 3,7 ГБ. Переменная data объявлена внутри фигурных скобок цикла, поэтому в конце итерации она уничтожается. А вот память, на которую она указывала, никуда не девается: операционная система по-прежнему считает её занятой нашей программой.
На следующей итерации создаётся новый указатель data на новые 3,7 ГБ, и снова теряется. После трёх итераций программа занимает около 11 ГБ, но у неё нет ни одного указателя, чтобы с этой памятью работать или освободить её. Написать delete[] data; после цикла тоже нельзя: переменной data там уже не существует.
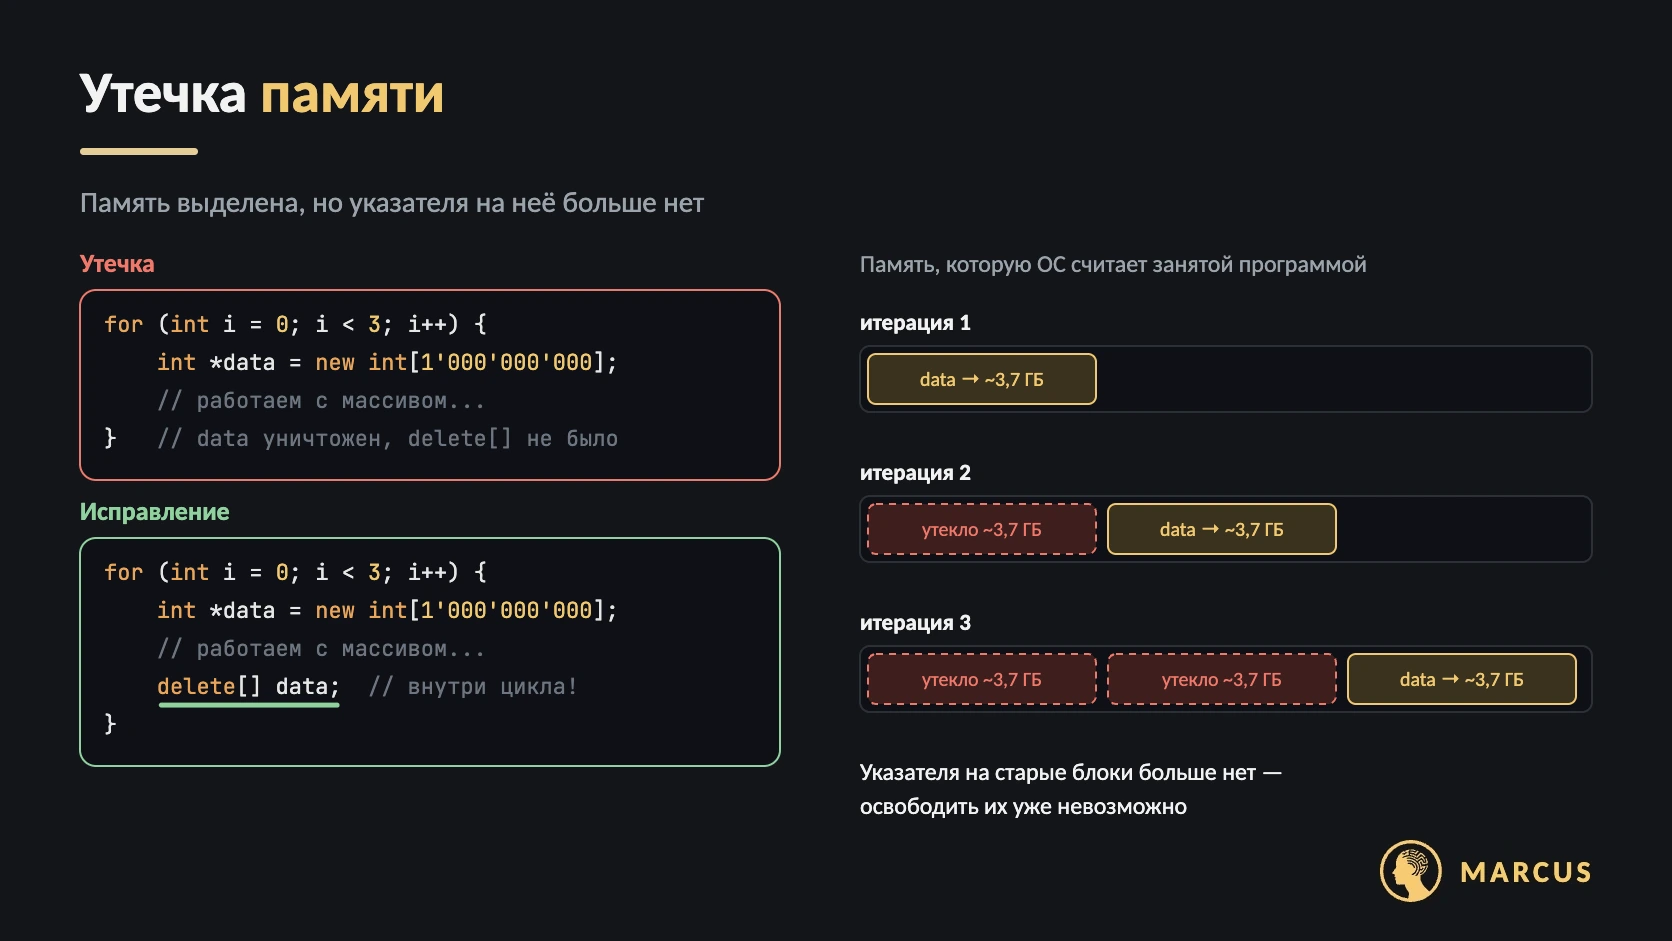
Утёкшая память остаётся занятой, пока программа работает. Её освободит только завершение программы: либо обычное, через return 0, либо аварийное. Если процесс начинает очень быстро съедать память, в Linux его может остановить специальный системный процесс — OOM killer (Out Of Memory killer).
Исправление — освобождать память внутри цикла, в конце каждой итерации, пока указатель ещё жив:
for (int i = 0; i < 3; i++) {
    int *data = new int[1'000'000'000];
    // работаем с массивом...
    delete[] data;
}Частые ошибки при работе с динамической памятью
| Ошибка | Что происходит | Как исправить |
|---|---|---|
Большой массив на стеке: int a[2'500'000]; | Переполнение стека, код 139 (SIGSEGV) | Выделить массив в куче: int *a = new int[n]; |
Забыли delete[] | Утечка памяти: память занята до конца работы программы | Освобождать память, когда она больше не нужна |
delete[] после цикла для указателя, объявленного в цикле | Ошибка компиляции: переменной уже нет | Писать delete[] в конце тела цикла |
delete вместо delete[] для массива | Неопределённое поведение | Пара new[] — delete[], пара new — delete |
Обращение к массиву после delete[] | Неопределённое поведение: мусор или аварийное завершение | Не использовать указатель после освобождения, присвоить ему nullptr |
Двойной delete[] одного указателя | Неопределённое поведение, часто аварийное завершение | Освобождать память ровно один раз |
Ожидание, что p + 1 сдвигает на 1 байт | Неверный адрес в расчётах | Сдвиг равен sizeof(T) байт |
| Слишком большой запрос: памяти не хватило | new выбрасывает исключение std::bad_alloc, программа аварийно завершается | Запрашивать разумный объём и проверять размер перед выделением |
Задачи на динамическую память
Закрепите материал в контесте к уроку. В нём пять заданий:
- Почему программа упала. Определите, почему массив на 2,5 миллиона элементов приводит к коду 139.
- Адресная арифметика. Посчитайте, что выведет программа, в которой указатель сдвигается по массиву.
- new, delete и указатели. Сопоставьте записи
new int(5),new int[5],delete,delete[],*(p + 2)иsizeof(int *)с их смыслом. - Расставьте new и delete. Допишите программу с динамическим массивом так, чтобы в ней не было утечки памяти.
- Фибоначчи по запросам. Посчитайте миллионы чисел Фибоначчи и ответьте на запросы. Массив такого размера в стек не поместится — понадобится
new[].
Решая задачи, рисуйте память: где лежит указатель, где — сам массив, на какой элемент указывает p + i. Так ошибки становятся видны ещё до запуска программы.
Подведём итоги
В этой статье Вы научились выделять память в куче и узнали, как массивы устроены изнутри.
Главное, что нужно запомнить:
- массив — непрерывный участок памяти из элементов одного типа. Имя массива в выражениях превращается в указатель на нулевой элемент;
sizeofвозвращает размер типа, переменной или массива в байтах;p + valueсдвигает указатель наsizeof(T) * valueбайт — наvalueэлементов;data[i]— это*(data + i): квадратные скобки — синтаксический сахар для адресной арифметики;- стек — небольшая область фиксированного размера (около 8 МБ на Linux и macOS), где живут обычные переменные. Большой массив в нём не поместится;
- куча — динамическая память, которую программа запрашивает во время работы. Её объём ограничен только свободной оперативной памятью;
- массив в куче создаётся через
new T[n]и освобождается черезdelete[], одиночный объект — черезnewиdelete; - если потерять указатель, не освободив память, произойдёт утечка памяти.
В следующем уроке разберём динамические матрицы: как выделить в куче двумерный массив и правильно его освободить. Эта тема часто вызывает трудности у школьников и студентов, поэтому ей посвящён отдельный урок.
Теория без практики быстро забывается, поэтому обязательно закрепите материал. Авторизуйтесь на сайте, отметьте статью как прочитанную и перейдите во вкладку «Решать задачи». Отправляйте решения на проверку, разбирайте результаты тестов и отслеживайте свой прогресс.
Продолжить изучение динамической памяти, функций и объектно-ориентированного программирования можно в курсе C++ с нуля с автоматической проверкой задач.
Использованная литература
- Рабочий проект стандарта C++: выражение new [Электронный ресурс]. — URL: https://eel.is/c++draft/expr.new (дата обращения: 13.11.2026).
- Рабочий проект стандарта C++: выражение delete [Электронный ресурс]. — URL: https://eel.is/c++draft/expr.delete (дата обращения: 13.11.2026).
- Рабочий проект стандарта C++: оператор sizeof [Электронный ресурс]. — URL: https://eel.is/c++draft/expr.sizeof (дата обращения: 13.11.2026).
- Рабочий проект стандарта C++: аддитивные операторы [Электронный ресурс]. — URL: https://eel.is/c++draft/expr.add (дата обращения: 13.11.2026).
- Рабочий проект стандарта C++: преобразование массива в указатель [Электронный ресурс]. — URL: https://eel.is/c++draft/conv.array (дата обращения: 13.11.2026).
- Выражение new [Электронный ресурс]. — URL: https://en.cppreference.com/w/cpp/language/new (дата обращения: 13.11.2026).
- Выражение delete [Электронный ресурс]. — URL: https://en.cppreference.com/w/cpp/language/delete (дата обращения: 13.11.2026).
- Арифметика указателей [Электронный ресурс]. — URL: https://en.cppreference.com/w/cpp/language/operator_arithmetic (дата обращения: 13.11.2026).